
SQLの「GROUP BY」句は、指定した列の値が同じ行を1つのグループにまとめ、グループごとに集計するための句です。COUNTやSUMなどの集計関数と組み合わせると、「男女別の人数」「性別ごとの平均点」のような集計結果をグループごとに1行ずつ取得できます。
本記事では、サンプルテーブルと実行結果を使いながら、次の内容を解説します。
- GROUP BYの基本構文と、COUNT・SUM・AVG・MAX・MINでの集計方法
- 「SELECT句の列でエラーになる」原因と対処法
- WHERE・HAVINGでの絞り込み、ORDER BYでの並び替え
- DISTINCTやPARTITION BYとの違い
GROUP BYとは?同じ値の行をまとめてグループごとに集計する句
GROUP BY句は、SELECT文の中で使う句の1つです。GROUP BYに指定した列の値が同じ行どうしが1つのグループになり、集計結果はグループごとに1行ずつ返されます。
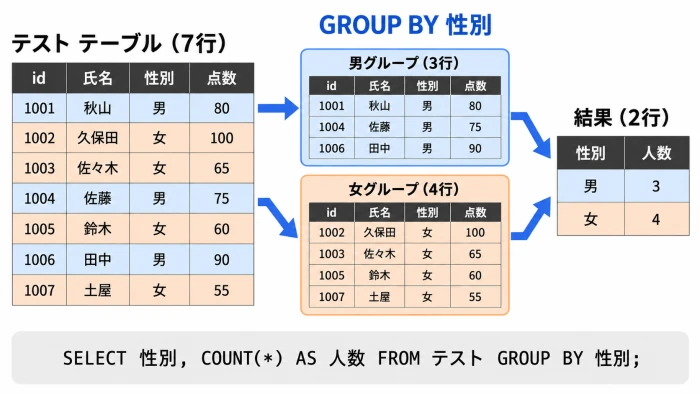
たとえば、7人分のテスト結果を「性別」でグループ化すると、「男」と「女」の2つのグループができます。そこに集計関数のCOUNTを組み合わせると、男女それぞれの人数を2行の結果として取得できます。
【GROUP BY句の使用イメージ】
GROUP BYの基本構文と書く順番
【基本構文】
SELECT グループ化する列, 集計関数(列)
FROM テーブル名
GROUP BY グループ化する列;
GROUP BY句は「FROM」句の後ろに書きます。WHERE・HAVING・ORDER BYと組み合わせる場合は、次の順番で記述します([ ]内は必要なときだけ書きます)。
SELECT グループ化する列, 集計関数(列)
FROM テーブル名
[WHERE 行の条件]
GROUP BY グループ化する列
[HAVING グループの条件]
[ORDER BY 並び替える列];なお、SQLは書いた順番どおりに処理されるわけではありません。論理的には「FROM → WHERE → GROUP BY → HAVING → SELECT → ORDER BY」の順に処理されます。この順番を知っておくと、後ほど解説するWHEREとHAVINGの違いや、SELECT句に書ける列のルールが理解しやすくなります。
| 順番 | 書く順番 | 処理される順番(論理的な順番) |
| 1 | SELECT | FROM |
| 2 | FROM | WHERE |
| 3 | WHERE | GROUP BY |
| 4 | GROUP BY | HAVING |
| 5 | HAVING | SELECT |
| 6 | ORDER BY | ORDER BY |
※実際の実行手順は、データベースが作る実行計画によって異なります。処理順についてはSELECT文の解説記事でも詳しく紹介しています。
この記事で使うサンプルテーブル
この記事では、以下の「テスト」テーブルを使って解説します。
「テスト」テーブル
+------+--------+------+------+
| id   | 氏名   | 性別 | 点数 |
+------+--------+------+------+
| 1001 | 秋山   | 男   |  80  |
| 1002 | 久保田 | 女   | 100  |
| 1003 | 佐々木 | 女   |  65  |
| 1004 | 佐藤   | 男   |  75  |
| 1005 | 鈴木   | 女   |  60  |
| 1006 | 田中   | 男   |  90  |
| 1007 | 土屋   | 女   |  55  |
+------+--------+------+------+
【テーブル作成用クエリ】
CREATE TABLE テスト (
  id   INT PRIMARY KEY,
  氏名 VARCHAR(20),
  性別 VARCHAR(2),
  点数 INT
);

INSERT INTO テスト (id, 氏名, 性別, 点数) VALUES
(1001, '秋山',   '男',  80),
(1002, '久保田', '女', 100),
(1003, '佐々木', '女',  65),
(1004, '佐藤',   '男',  75),
(1005, '鈴木',   '女',  60),
(1006, '田中',   '男',  90),
(1007, '土屋',   '女',  55);
※本記事の実行結果は、MySQL 8.0で実行した場合の出力例です。SQL Serverで日本語を扱う場合は列の型をNVARCHARにして値に「N'男'」のようにNを付け、Oracleでは「VARCHAR2(2 CHAR)」のように文字数で長さを指定してください。
GROUP BYと集計関数でグループごとに集計する
集計関数を使用することで、GROUP BYでグループ化したデータの集計結果を取得することができます。
集計関数とは
集計関数とは、その項目の合計値や平均値を求めたり、あるいはCOUNT関数のようにデータ件数を取得するなど、その名の通り集計を行う関数のことです。これらを利用することで都度計算する必要がなくなり、データ分析などに使うと便利です。後ほど詳しく紹介しますが、集計関数とそれぞれ用途を以下に示しました。
【集計関数の種類と用途】
| 集計関数 | 用途 |
| COUNT | 項目のデータ件数を取得する |
| SUM | 項目のデータ合計値を取得する |
| AVG | 項目のデータ平均値を取得する |
| MAX | 項目のデータ最大値を取得する |
| MIN | 項目のデータ最小値を取得する |
COUNT関数でグループごとの件数を数える
「COUNT」関数はグループ化したデータの件数を集計します。「GROUP BY」と併用して、テストを受けた生徒の男女別の人数を求めてみましょう。
【実行クエリ】
SELECT 性別, COUNT(*) AS 人数 FROM テスト GROUP BY 性別;【実行結果】
+------+------+
| 性別 | 人数 |
+------+------+
| 男   |  3   |
| 女   |  4   |
+------+------+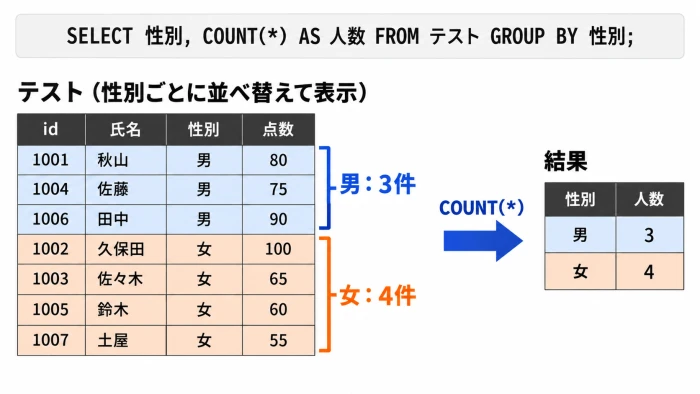
「性別」でグループ化を行い、性別ごとの人数を取得しています。このように、「GROUP BY」句と「COUNT」関数を併用すればグループごとのレコード数を集計できます。
行数を数えるときは「COUNT(*)」を使うのが基本です。「COUNT(性別)」のように列名を指定すると、その列がNULLの行は数えられません。COUNT(*)とCOUNT(列名)の違いは、こちらのページで詳しく解説しています。

SUM関数でグループごとの合計を求める
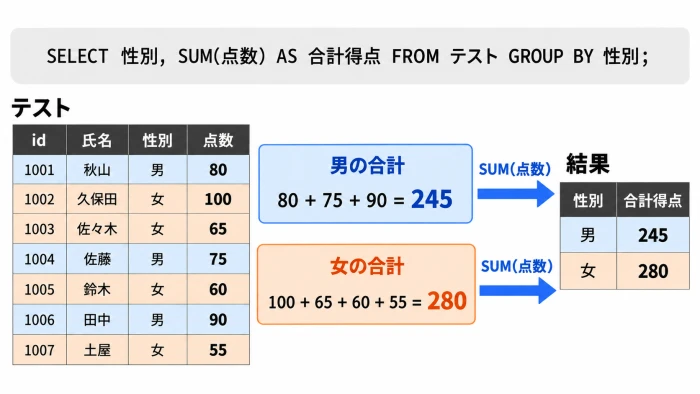
SUM関数はデータの合計値を算出することができます。試しに、男女別の合計得点を出してみましょう。
【実行クエリ】
SELECT 性別, SUM(点数) AS 合計得点 FROM テスト GROUP BY 性別;【実行結果】
+------+----------+
| 性別 | 合計得点 |
+------+----------+
|  男  |   245    |
|  女  |   280    |
+------+----------+
AVG関数でグループごとの平均を求める(四捨五入・切り捨ても)
AVG関数はデータの平均値を算出することができます。試しに、性別ごとの平均点を計算してみましょう。
【実行クエリ】
SELECT 性別, AVG(点数) AS 平均点 FROM テスト GROUP BY 性別;【実行結果】
+------+---------+
| 性別 | 平均点  |
+------+---------+
|  男  | 81.6667 |
|  女  | 70.0000 |
+------+---------+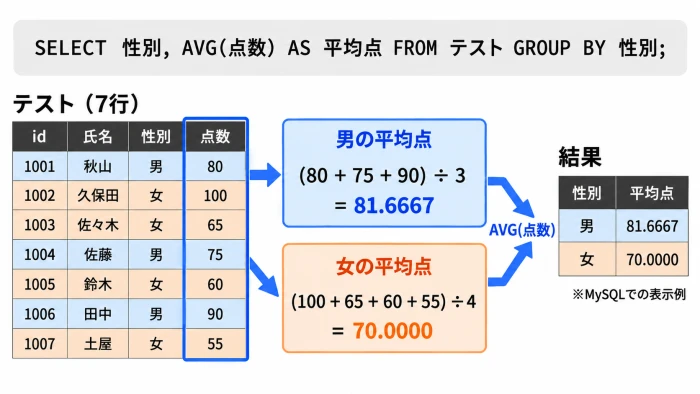
MySQLでは、整数の平均は小数第4位まで表示されます。平均値の表示はデータベースによって異なるため注意しましょう。
| データベース | 男の平均点の表示 | 備考 |
| MySQL | 81.6667 | 小数第4位まで表示 |
| PostgreSQL | 81.6666666666666667 | 整数の平均はnumeric型になる |
| SQL Server | 81 | 整数(INT)の平均は整数で返される |
| SQLite | 81.6666666666667 | 浮動小数点数で返される |
SQL Serverで小数まで求めたい場合は、「AVG(点数 * 1.0)」のように小数に変換してから平均を求めます。
平均値を四捨五入して表示したい場合は、ROUND関数を使います。以下は、小数第2位を四捨五入して小数第1位まで表示する例です。
【実行クエリ】
SELECT 性別, ROUND(AVG(点数), 1) AS 平均点 FROM テスト GROUP BY 性別;【実行結果】
+------+--------+
| 性別 | 平均点 |
+------+--------+
|  男  |  81.7  |
|  女  |  70.0  |
+------+--------+
切り捨てに使う関数は、データベースによって名前や書き方が異なります。主なデータベースの書き方は以下のとおりです。
| 処理 | MySQL | PostgreSQL / Oracle | SQL Server |
| 小数第2位まで残して四捨五入 | ROUND(値, 2) | ROUND(値, 2) | ROUND(値, 2) |
| 小数第2位まで残して切り捨て | TRUNCATE(値, 2) | TRUNC(値, 2) | ROUND(値, 2, 1) |
| 小数点以下を切り捨て | TRUNCATE(値, 0) | TRUNC(値) | ROUND(値, 0, 1) |
SQL ServerのROUND関数は、桁数の指定(2つ目の引数)を省略できません。また、FLOOR関数(どのデータベースにもあります)でも小数点以下を切り捨てられますが、桁数は指定できず、負の数では結果が変わります(FLOOR(-1.5)は-2、TRUNC(-1.5)は-1)。
MAX・MIN関数でグループごとの最大値・最小値を求める
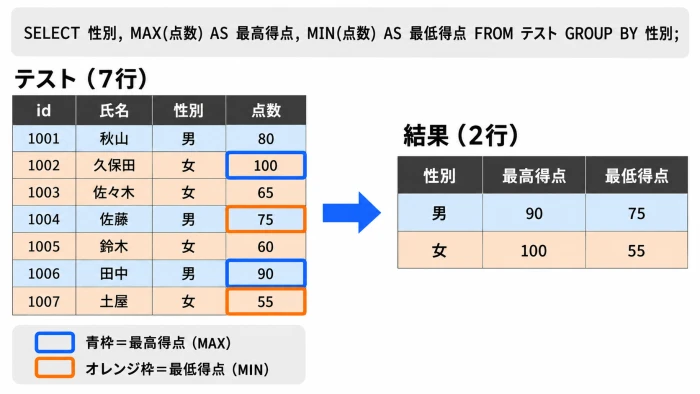
MAX関数はデータの最大値、MIN関数は最小値を取得できます。1つのSELECT文の中で複数の集計関数を同時に使うこともできるので、性別ごとの最高得点と最低得点をまとめて取得してみましょう。
【実行クエリ】
SELECT 性別, MAX(点数) AS 最高得点, MIN(点数) AS 最低得点 FROM テスト GROUP BY 性別;【実行結果】
+------+----------+----------+
| 性別 | 最高得点 | 最低得点 |
+------+----------+----------+
|  男  |    90    |    75    |
|  女  |   100    |    55    |
+------+----------+----------+
複数のカラムでグループ化する
ここまでは「性別」という1つのカラムでグループ化してきましたが、GROUP BY句はカンマ区切りで複数のカラムを指定することもできます。この場合、指定したカラムの値の組み合わせが同じレコードごとに1つのグループとして扱われます。
ここまで使用してきた「テスト」テーブルは性別以外にグループ化できる項目がないため、性別に加えて「学年」の情報を持つ、以下のような別のテーブルを例に考えてみましょう。
「生徒」テーブル
+--------+------+------+
| 氏名   | 性別 | 学年 |
+--------+------+------+
| 高橋   | 男   | 1年  |
| 伊藤   | 女   | 1年  |
| 渡辺   | 男   | 1年  |
| 小林   | 女   | 2年  |
| 中村   | 男   | 2年  |
| 加藤   | 女   | 2年  |
+--------+------+------+
性別と学年の組み合わせごとに人数を集計したい場合は、以下のようにGROUP BY句の後ろにカラム名をカンマで区切って指定します。
【実行クエリ】
SELECT 性別, 学年, COUNT(*) AS 人数 FROM 生徒 GROUP BY 性別, 学年;【実行結果】
+------+------+------+
| 性別 | 学年 | 人数 |
+------+------+------+
| 男   | 1年  |  2   |
| 女   | 1年  |  1   |
| 男   | 2年  |  1   |
| 女   | 2年  |  2   |
+------+------+------+
このように、「性別」と「学年」が同じ組み合わせのレコードごとに1つのグループとして集計されます。集計軸を増やしたい場合は、同様にカラム名をカンマで追加していくだけで対応できます。
GROUP BYを使うときの注意点とよくあるエラー
GROUP BY句を使用するうえで、いくつか気を付けなければいけない点があります。
SELECT句にはGROUP BYの列と集計関数だけを書く
GROUP BYを使ったSELECT文では、SELECT句に書ける列は「GROUP BYに指定した列」と「集計関数」だけです。それ以外の列をそのまま書くと、多くのデータベースでエラーになります。
【NG例】
SELECT 性別, 氏名 FROM テスト GROUP BY 性別;性別でグループ化すると、たとえば「女」のグループには久保田・佐々木・鈴木・土屋の4人が含まれます。グループの結果は1行にまとめられるため、4人のうちどの氏名を表示すればよいか決められません。そのため、次のようなエラーになります。
| データベース | NG例を実行したときの結果 |
| MySQL 5.7.5以降 | エラー(ERROR 1055)。初期設定で有効になっている「ONLY_FULL_GROUP_BY」モードによるもの |
| PostgreSQL | エラー(column “テスト.氏名” must appear in the GROUP BY clause or be used in an aggregate function) |
| SQL Server | エラー(Msg 8120:集計関数またはGROUP BY句に含まれていないため、選択リスト内では無効です) |
| Oracle | エラー(ORA-00979:GROUP BYの式ではありません) |
| SQLite | エラーにならず、グループ内のいずれか1行の氏名が表示される |
SQLiteや、ONLY_FULL_GROUP_BYを無効にしたMySQLではエラーになりませんが、どの行の値が表示されるかは決まっていません。エラーにならない環境でも、このような書き方は避けましょう。
なお、逆にGROUP BYに指定した列をSELECT句に書かないのは問題ありません。「SELECT COUNT(*) FROM テスト GROUP BY 性別;」は正しく実行でき、人数だけが2行表示されます。
NG例のように氏名も表示したい場合は、目的に合わせて次のいずれかの方法で書き直します。
- GROUP BYに列を追加する:「GROUP BY 性別, 氏名」とすると、グループの単位が「性別と氏名の組み合わせ」に変わります(今回のデータでは1人ずつのグループになります)
- 集計関数で1つの値にまとめる:氏名の件数を数えるならCOUNT、最高得点を求めるならMAXのように、集計関数を使います
- グループ内の値を連結して表示する:グループに含まれる氏名を一覧で表示したい場合は、文字列を連結する集計関数を使います
MySQLでは、GROUP_CONCAT関数を使ってグループ内の氏名をカンマ区切りで表示できます。
【実行クエリ】
SELECT 性別, GROUP_CONCAT(氏名 ORDER BY id) AS 氏名一覧 FROM テスト GROUP BY 性別;【実行結果】
+------+--------------------------+
| 性別 | 氏名一覧                 |
+------+--------------------------+
| 男   | 秋山,佐藤,田中           |
| 女   | 久保田,佐々木,鈴木,土屋  |
+------+--------------------------+
同じ処理は、PostgreSQLやSQL Server 2017以降ではSTRING_AGG関数、OracleではLISTAGG関数で書けます。
NULLは1つのグループにまとめられる
GROUP BYで指定した列に「NULL」値が含まれている場合、NULLの行はすべてまとめて1つのグループとして集計されます。たとえば性別が未登録(NULL)の生徒がいた場合、結果には「男」「女」に加えて性別がNULLの行が1行表示されます。
また、COUNT(*)以外の集計関数はNULLを無視して計算します。たとえば点数がNULLの生徒がいる場合、AVG(点数)はその生徒を除いた人数で平均を計算します。
NULLのグループを結果に含めたくない場合は、グループ化の前にWHERE句で除外します。
SELECT 性別, COUNT(*) AS 人数 FROM テスト WHERE 性別 IS NOT NULL GROUP BY 性別;NULLの判定方法(IS NULL / IS NOT NULL)については、NULLの扱い方の解説記事をご覧ください。
WHEREとHAVINGで集計する対象を絞り込む
「GROUP BY」句と併せて「WHERE」句または「HAVING」句を使用することで、集計する対象を条件で絞り込むことができます。
WHEREとHAVINGの違いは「グループ化の前か後か」
「WHERE」句と「HAVING」句は、条件が適用されるタイミングが異なります。冒頭で紹介した処理順「FROM → WHERE → GROUP BY → HAVING → SELECT → ORDER BY」のとおり、WHEREはグループ化の前、HAVINGはグループ化の後に処理されます。
「WHERE」句:「GROUP BY」句の実行前に、行に対して条件が適用される
「HAVING」句:「GROUP BY」句の実行後に、グループ(集計結果)に対して条件が適用される
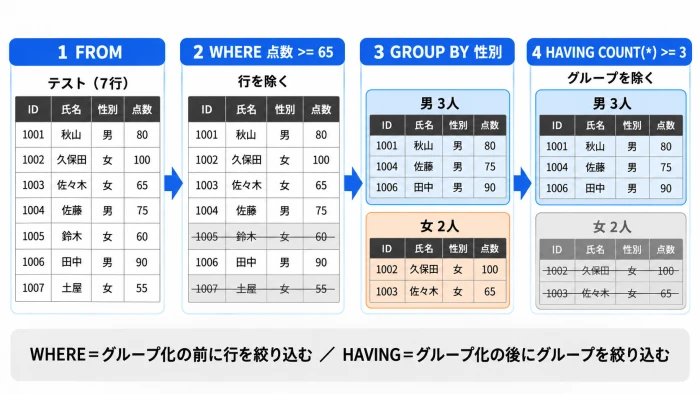
グループ化の前に任意の条件を満たさないレコードを省く場合は「WHERE」句を使い、グループ化後に任意の条件を満たさないグループを省く場合に「HAVING」句を使います。COUNTやSUMなど集計結果を使った条件はHAVINGにしか書けません。
WHEREでグループ化する前の行を絞り込む
「GROUP BY」句と「WHERE」句の併用例を解説していきます。「テスト」テーブルを用いて、テストの点数が60点未満の生徒を除いた人数を男女別で表示させましょう。
【実行クエリ】
SELECT 性別, COUNT(*) AS 人数 FROM テスト WHERE 点数 >= 60 GROUP BY 性別;【実行結果】
+------+------+
| 性別 | 人数 |
+------+------+
| 男   |  3   |
| 女   |  3   |
+------+------+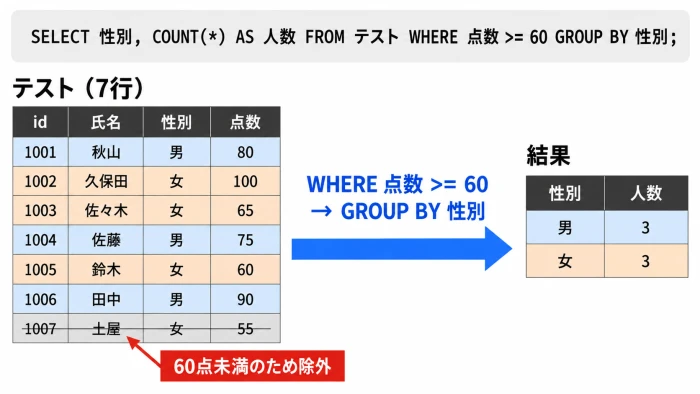
グループ化の前に60点未満の土屋さんが除かれたことで、60点以上の生徒は男子が3名、女子が3名となりました。
また、こちらの記事で「WHERE」句について詳しく解説していますので、ぜひこちらもご覧ください!

HAVINGでグループ化した後の集計結果を絞り込む
続いて、「GROUP BY」句と「HAVING」句の併用例を解説していきます。「テスト」テーブルのうち、人数が3人以下のグループのみ表示させましょう。
【実行クエリ】
SELECT 性別, COUNT(*) AS 人数 FROM テスト GROUP BY 性別 HAVING COUNT(*) <= 3;【実行結果】
+------+------+
| 性別 | 人数 |
+------+------+
| 男   |  3   |
+------+------+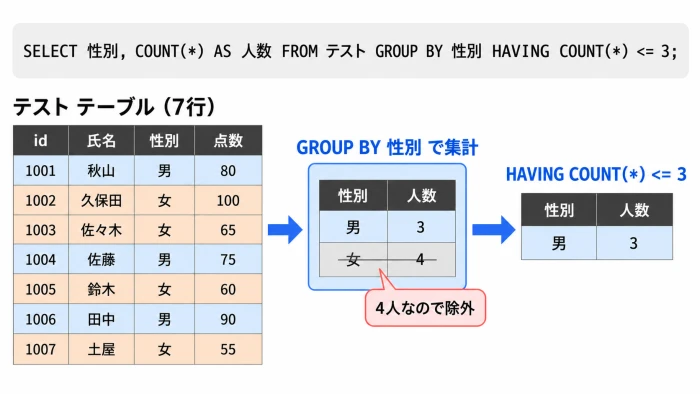
人数が4人の女子のグループが除かれたことで、男子のグループのみが表示されました。
HAVINGの条件には、「HAVING 人数 <= 3」のようにSELECT句で付けた別名(人数)を書かず、「COUNT(*)」のように集計式をそのまま書きましょう。別名を使った書き方はMySQLなどでは動きますが、PostgreSQLやSQL Serverではエラーになります(詳しくはよくある質問で解説します)。
「HAVING」句についてもっと詳しく知りたいという方は、こちらの記事もお読みください!

ORDER BYで集計結果を並び替える
「ORDER BY」句とは、任意のカラム(列)に基づいて結果をソート(並び替え)する句です。GROUP BYだけでは結果の並び順は保証されないため、決まった順番で表示したいときは必ずORDER BYを付けましょう。ここまでの例で「男」「女」の順に表示されていたのは、たまたまその順番になっていただけです。
例として、性別ごとにまとめたグループを人数の多い順に並び替えます。
【実行クエリ】
SELECT 性別, COUNT(*) AS 人数 FROM テスト GROUP BY 性別 ORDER BY 人数 DESC;【実行結果】
+------+------+
| 性別 | 人数 |
+------+------+
| 女   |  4   |
| 男   |  3   |
+------+------+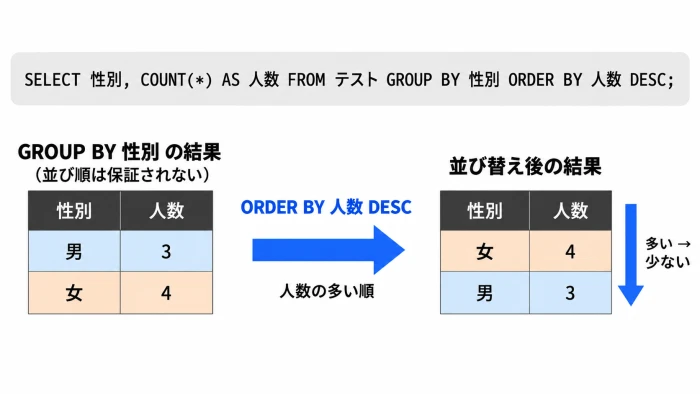
「ORDER BY」句を併用することで、人数の多いグループから少ないグループの順に並び替えることができました。ORDER BYは処理順の最後に実行されるため、SELECT句で付けた別名(人数)をそのまま指定できます。
クエリの最後に記述している「DESC」は”descending”(下っている)の略称で、「降順」(大きいものから小さいものへ下っていく並び順)を表しています。
反対に、昇順(値が小さいものから大きいものへ)の場合は「ASC」を使用します。こちらは”ascending”(上っている)の略称です。
GROUP BYと似た構文との違い
GROUP BYと似た働きをする構文に、DISTINCTとPARTITION BYがあります。それぞれの違いを確認しておきましょう。
DISTINCTとの違い
DISTINCTは、SELECTの結果から重複した行を取り除くキーワードです。次の2つのクエリは、どちらも「男」「女」の2行を返します。
SELECT DISTINCT 性別 FROM テスト;
SELECT 性別 FROM テスト GROUP BY 性別;違いは、GROUP BYはグループごとに集計関数で計算できる点です。重複を取り除いた一覧が欲しいだけならDISTINCT、人数や合計などを求めたいならGROUP BYを使うと、クエリの意図が伝わりやすくなります。
DISTINCTの使い方は、DISTINCTの解説記事で詳しく紹介しています。
PARTITION BY(ウィンドウ関数)との違い
PARTITION BYも、GROUP BYと同じように基準となる列でデータをグループに分ける働きがあります。ただし、PARTITION BYは「ウィンドウ関数」(SUM() OVERやRANKなど)の中で使い、行を1行にまとめずに、元の行数を保ったままグループごとの計算結果を各行に表示します。
次のクエリは、性別ごとの平均点を、生徒1人ひとりの行に並べて表示します。
【実行クエリ】
SELECT 氏名, 性別, 点数,
       AVG(点数) OVER (PARTITION BY 性別) AS 性別平均
FROM テスト
ORDER BY id;
【実行結果】
+--------+------+------+----------+
| 氏名   | 性別 | 点数 | 性別平均 |
+--------+------+------+----------+
| 秋山   | 男   |  80  | 81.6667  |
| 久保田 | 女   | 100  | 70.0000  |
| 佐々木 | 女   |  65  | 70.0000  |
| 佐藤   | 男   |  75  | 81.6667  |
| 鈴木   | 女   |  60  | 70.0000  |
| 田中   | 男   |  90  | 81.6667  |
| 土屋   | 女   |  55  | 70.0000  |
+--------+------+------+----------+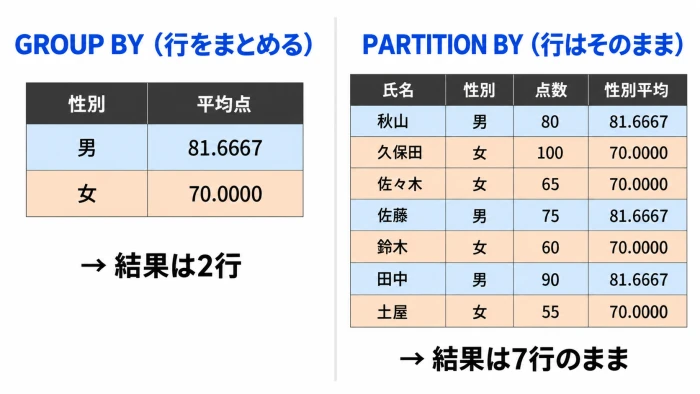
GROUP BYで平均を求めると結果は2行になりますが、PARTITION BYでは7行のまま、各行に性別ごとの平均点が表示されます。「自分の点数と平均点を比べたい」のように、元の行と集計結果を並べたいときはPARTITION BYを使います。
※ウィンドウ関数は、MySQLでは8.0以降、SQLiteでは3.25以降で使用できます。
GROUP BYに関するよくある質問
GROUP BYやHAVINGで別名(エイリアス)は使える?
データベースによって異なります。SELECT句で「AS 人数」のように付けた別名をGROUP BY・HAVINGで使えるかどうかは、次のとおりです。
| データベース | GROUP BYで別名 | HAVINGで別名 |
| MySQL | 使える | 使える |
| SQLite | 使える | 使える |
| PostgreSQL | 使える | 使えない |
| SQL Server | 使えない | 使えない |
| Oracle(21c以前) | 使えない | 使えない |
| Oracle(23ai以降) | 使える | 使える |
どのデータベースでも動くようにするには、GROUP BYやHAVINGには別名ではなく元の列名や集計式(COUNT(*)など)を書きましょう。なお、ORDER BYではどのデータベースでも別名を使えます。
グループごとに最大値を持つ行(氏名など)を取り出すには?
「男女それぞれの最高得点者の氏名」のように、最大値を持つ行全体を取り出したい場合、GROUP BYとMAX関数だけでは氏名を表示できません(SELECT句のルールでエラーになります)。この場合は、ウィンドウ関数のROW_NUMBERを使って、グループ内で順位を付けてから1位の行を取り出します。
【実行クエリ】
SELECT 氏名, 性別, 点数
FROM (
  SELECT 氏名, 性別, 点数,
         ROW_NUMBER() OVER (PARTITION BY 性別 ORDER BY 点数 DESC) AS 順位
  FROM テスト
) t
WHERE 順位 = 1;
【実行結果】
+--------+------+------+
| 氏名   | 性別 | 点数 |
+--------+------+------+
| 久保田 | 女   | 100  |
| 田中   | 男   |  90  |
+--------+------+------+
同点の生徒をすべて表示したい場合は、ROW_NUMBERの代わりにRANKを使います。
重複しているデータ(2件以上あるデータ)を探すには?
重複を調べたい列でGROUP BYし、HAVINGで件数が2件以上のグループだけを残します。たとえば会員テーブルで、同じメールアドレスが2回以上登録されていないかを調べるクエリは次のとおりです。
SELECT メールアドレス, COUNT(*) AS 件数
FROM 会員
GROUP BY メールアドレス
HAVING COUNT(*) >= 2;
結果には、重複しているメールアドレスと、その登録件数が表示されます。
SQL関連記事
- RDBを操作するデータベース言語「SQL」とは?
- RDB以外のデータベース管理システム「NoSQL」とは?
- RDB管理システム「MySQL」とは?
- RDB管理システム「PostgreSQL」とは?
- RDB管理システム「SQL Server」とは?
- RDB管理システム「SQLite」とは?
- ブラウザ上でMySQLを管理できる「phpMyAdmin」とは?
- データを抽出する「SELECT」文
- データを追加する「INSERT」文
- データを削除する「DELETE」文
- データを更新する「UPDATE」文
- 抽出条件を指定する「WHERE」句
- 抽出条件を指定する「HAVING」句
- 複数の抽出条件をまとめる「IN」句
- 重複レコードを除外する「DISTINCT」
- 抽出範囲を指定する「BETWEEN」演算子
- 抽出条件を満たすレコードの存在の有無を調べる「EXISTS」句
- レコード件数を取得する集計関数「COUNT」関数
- 抽出結果を並び替える「ORDER BY」句
- テーブル間のデータを結合する「JOIN」句
- 内部結合「INNER JOIN」句
- 抽出結果を統合して表示する「UNION」句
- データの曖昧検索「LIKE」句
- 条件分岐処理「CASE」式
- 文字列の余白を取り除く「TRIM」関数
- 「NULL」の扱い方
- 「主キー」とは?
- 「外部キー」とは?
SQLの勉強方法は?
書籍やインターネットで学習する方法があります。昨今では、YouTubeなどの動画サイトやエンジニアのコミュニティサイトなども充実していて多くの情報が手に入ります。
そして、より効率的に知識・スキルを習得するには、知識をつけながら実際に手を動かしてみるなど、インプットとアウトプットを繰り返していくことが重要です。特に独学の場合は、有識者に質問ができたりフィードバックをもらえるような環境があると、理解度が深まるでしょう。
ただ、SQLに限らず、ITスキルを身につける際、どうしても課題にぶつかってしまうことはありますよね。特に独学だと、わからない部分をプロに質問できる機会を確保しにくく、モチベーションが続きにくいという側面があります。独学でモチベーションを維持する自信がない人にはプログラミングスクールという手もあります。費用は掛かりますが、その分スキルを身につけやすいです。しっかりと知識・スキルを習得して実践に活かしたいという人はプログラミングスクールがおすすめです。
プログラミングスクールならテックマニアがおすすめ!
ITスキル需要の高まりとともにプログラミングスクールも増えました。しかし、どのスクールに通うべきか迷ってしまう人もいるでしょう。そんな方にはテックマニアをおすすめします!これまで多くのITエンジニアを育成・輩出してきたテックマニアでもプログラミングスクールを開講しています。
<テックマニアの特徴>
・たしかな育成実績と親身な教育 ~セカンドキャリアを全力支援~
・講師が現役エンジニア ~“本当”の開発ノウハウを直に学べる~
・専属講師が学習を徹底サポート ~「わからない」を徹底解決~
・実務ベースでスキルを習得 ~実践的な凝縮カリキュラム~
このような特徴を持つテックマニアはITエンジニアのスタートラインとして最適です。
話を聞きたい・詳しく知りたいという方はこちらからお気軽にお問い合わせください。