
SQLのCOUNTは、テーブルの行数や条件に合うデータの件数を数える集計関数です。COUNT(*)はNULLを含むすべての行を、COUNT(列名)はその列がNULLの行を除いて数えるため、同じテーブルでも書き方によって結果が変わります。
この記事では、COUNTの基本構文から、COUNT(*)とCOUNT(列名)の違い、重複を除いた件数の数え方(DISTINCT)、条件に合う件数の数え方、GROUP BYでのグループごとの件数、COUNT(1)との違いまで、サンプルテーブルと実行結果を使って解説します。
SQLのCOUNTとは?行数・件数を数える集計関数
SQLのCOUNTとは、行の数、または指定した列(式)の値がNULLでない行の数を返す集計関数(複数行のデータをまとめて1つの値を返す関数)です。テーブル全体の件数だけでなく、重複を除いた件数、条件に合う件数、グループごとの件数も求められます。
COUNTは主にSELECT句の中で使いますが、HAVING句やORDER BY句の中で使うこともできます。
COUNTの基本構文
【基本構文】
SELECT COUNT(*) FROM テーブル名;この構文で、テーブルの行数(レコード数)を取得できます。条件に合う行だけを数えたい場合は、後ろにWHERE句を付けます。
カッコの中身で数える対象が変わる
COUNTのカッコの中身(引数)に何を指定するかで、数える対象が変わります。
| 書き方 | 数える対象 | NULL | 重複した値 |
| COUNT(*) | すべての行 | 数える | 数える |
| COUNT(列名) | その列の値がNULLでない行 | 数えない | 数える |
| COUNT(DISTINCT 列名) | NULLでない値の種類 | 数えない | 1つにまとめる |
| COUNT(1) | すべての行(COUNT(*)と同じ結果) | 数える | 数える |
NULLとは、「値が入っていない」もしくは「値が不明である」ことを表す特別な状態です。0や空文字('')とは別物で、COUNT(列名)が数えずに除外するのはこのNULLだけです。
NULLについてはこちらの記事でも詳しく扱っています。
 【SQL】NULLの扱い方をサンプルコードで分かりやすく解説
▶
COUNT(*)とCOUNT(列名)の違い
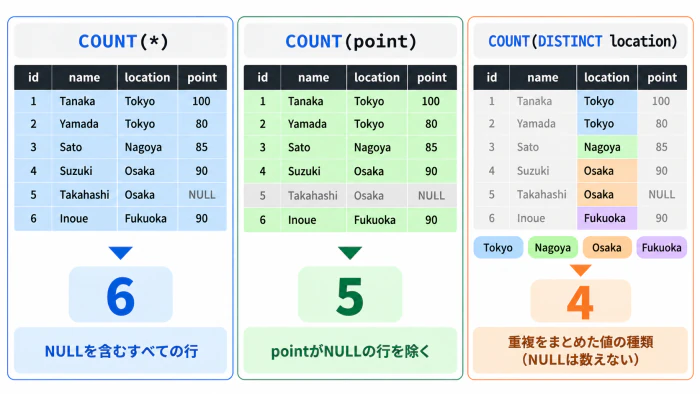
COUNT(*)は行そのものを数え、COUNT(列名)はその列がNULLの行を除いて数えます。そのため、指定した列にNULLが含まれていると、両者の結果が変わります。ここからはサンプルテーブルを使って、実際の結果を比べてみましょう。
サンプルテーブル
この記事では、サンプルとして次の「試験(test)」テーブルを使います。Takahashiさん(id=5)は点数(point)がNULLになっています。
「試験(test)」テーブル
| ID(id) | 名前(name) | 試験地(location) | 点数(point) |
| 1 | Tanaka | Tokyo | 100 |
| 2 | Yamada | Tokyo | 80 |
| 3 | Sato | Nagoya | 85 |
| 4 | Suzuki | Osaka | 90 |
| 5 | Takahashi | Osaka | NULL |
| 6 | Inoue | Fukuoka | 90 |
手元のデータベースで試したい場合は、次のSQLでテーブルを作成できます。
【テーブル作成用SQL】
CREATE TABLE test (
  id       INT PRIMARY KEY,
  name     VARCHAR(20),
  location VARCHAR(20),
  point    INT
);

INSERT INTO test (id, name, location, point) VALUES
  (1, 'Tanaka',    'Tokyo',   100),
  (2, 'Yamada',    'Tokyo',   80),
  (3, 'Sato',      'Nagoya',  85),
  (4, 'Suzuki',    'Osaka',   90),
  (5, 'Takahashi', 'Osaka',   NULL),
  (6, 'Inoue',     'Fukuoka', 90);
※Oracle Database 21c以前では、複数行をまとめてINSERTするこの書き方は使えないため、1行ずつINSERTしてください。
COUNT(*):NULLを含むすべての行を数える
【使用イメージ】
SELECT COUNT(*) FROM テーブル名;引数に「*(アスタリスク)」を指定すると、テーブルの行数を取得できます。COUNT(*)の「*」は、SELECT *の「すべての列」とは意味が異なり、特定の列の値を見ずに「行の数」を数える専用の書き方です。そのため、pointがNULLの行も、仮にすべての列がNULLの行であっても、1行として数えます。
【実行クエリ】
SELECT COUNT(*) FROM test;【実行結果】
| COUNT(*) |
| 6 |
結果の列名はデータベースによって異なります(MySQLやSQLiteでは「COUNT(*)」、PostgreSQLでは「count」、SQL Serverでは「(列名なし)」と表示されます)。わかりやすい列名を付けたい場合は、ASで別名を付けます。
【実行クエリ】
SELECT COUNT(*) AS 受験者数 FROM test;【実行結果】
| 受験者数 |
| 6 |
COUNT(列名):その列がNULLの行を除いて数える
【使用イメージ】
SELECT COUNT(列名) FROM テーブル名;COUNTの引数に列名を指定すると、その列の値がNULLの行を除いた行数を取得できます。
【実行クエリ】
SELECT COUNT(point) AS 点数登録者数 FROM test;【実行結果】
| 点数登録者数 |
| 5 |
Takahashiさん(id=5)はpointがNULLのため数えられず、結果は5になります。
なお、除外されるのはNULLだけです。0や空文字('')、FALSEなどは「値がある」ものとして数えられます。ただし、Oracle Databaseでは長さ0の文字列(空文字)がNULLとして扱われるため、空文字の行も数えられません。
COUNT(*)とCOUNT(列名)を並べて比較する
2つを1つのクエリで並べると、違いがよくわかります。
【実行クエリ】
SELECT COUNT(*) AS 全行数, COUNT(point) AS 点数あり FROM test;【実行結果】
| 全行数 | 点数あり |
| 6 | 5 |
同じテーブルでも、COUNT(*)は6、COUNT(point)は5と結果が変わりました。違いをまとめると、次のとおりです。
| 書き方 | 結果 | 理由 |
| COUNT(*) | 6 | pointがNULLの行も含め、すべての行を数える |
| COUNT(point) | 5 | pointがNULLの行(id=5)を除いて数える |
テーブルや条件に合う行の数そのものを知りたいときはCOUNT(*)、特定の列に値が入っている件数を知りたいときはCOUNT(列名)と使い分けましょう。
重複を除いて数える:COUNT(DISTINCT 列名)
COUNT(DISTINCT 列名)の使い方
【使用イメージ】
SELECT COUNT(DISTINCT 列名) FROM テーブル名;COUNTの引数の前にDISTINCTを付けると、重複した値を1つにまとめたうえで、値の種類の数を数えられます。
【実行クエリ】
SELECT COUNT(DISTINCT location) AS 会場数 FROM test;上記のクエリで、重複を除いた試験地の数、つまり試験会場の数が求められます。
【実行結果】
| 会場数 |
| 4 |
試験地はTokyoとOsakaがそれぞれ2件ずつ重複しているため、Tokyo・Nagoya・Osaka・Fukuokaの4種類として数えられます。
DISTINCTを付けない場合と並べると、違いがはっきりします。
【実行クエリ】
SELECT COUNT(location) AS 試験地の件数, COUNT(DISTINCT location) AS 会場数 FROM test;【実行結果】
| 試験地の件数 | 会場数 |
| 6 | 4 |
COUNT(location)は値が入っている行をすべて数えるため、同じ試験地が何度出てきても1件ずつ数えて6になります。「のべ人数」ならCOUNT(列名)、「何種類あるか(ユニーク数)」ならCOUNT(DISTINCT 列名)と覚えておきましょう。
 【SQL】DISTINCTで重複行を除外する方法を解説
▶
NULLを含む列にDISTINCTを使うとどうなる?
COUNT(DISTINCT 列名)でも、NULLは数えられません。たとえば、Satoさん(id=3)の試験地がまだ決まっておらず、locationがNULLになっている場合を考えます。
【試験地の一部がNULLの「試験(test)」テーブル】
| ID(id) | 名前(name) | 試験地(location) | 点数(point) |
| 1 | Tanaka | Tokyo | 100 |
| 2 | Yamada | Tokyo | 80 |
| 3 | Sato | NULL | 85 |
| 4 | Suzuki | Osaka | 90 |
| 5 | Takahashi | Osaka | NULL |
| 6 | Inoue | Fukuoka | 90 |
【実行クエリ】
SELECT COUNT(DISTINCT location) AS 会場数 FROM test;【実行結果】
| 会場数 |
| 3 |
結果は3となりました。NULLは「値の種類」として数えられず、Tokyo・Osaka・Fukuokaの3種類だけが数えられます。
条件に合う件数を数える
WHEREで条件に合う行だけ数える
【使用イメージ】
SELECT COUNT(*) FROM テーブル名 WHERE 条件;WHERE句は、条件を満たす行だけを取り出す句です。WHERE句で行を絞り込んでからCOUNTで数えるため、条件に合う件数を求められます。以降は元の「試験(test)」テーブル(Satoさんの試験地はNagoya)を使います。
【実行クエリ1】
SELECT COUNT(*) AS 受験者数 FROM test WHERE location = 'Tokyo';試験地がTokyoの行数を求めます。
【実行結果】
| 受験者数 |
| 2 |
【実行クエリ2】
SELECT COUNT(*) AS 高得点者数 FROM test WHERE point >= 90;点数が90点以上の行数を求めます。
【実行結果】
| 高得点者数 |
| 3 |
pointがNULLの行(id=5)は「point >= 90」の判定が真にならないため、WHERE句で除外されて数えられません。
※別名(AS)を「90点以上」のように数字で始めると、PostgreSQL・SQL Server・Oracle・SQLiteではエラーになります。数字で始まる別名を使いたい場合は"90点以上"のようにダブルクォーテーションで囲みましょう。
WHERE句の使い方は、こちらの記事で詳しく解説しています。
 【SQL入門】WHEREで検索条件を指定する方法を解説
▶
CASE式で条件ごとの件数を一度に数える
WHERE句で絞り込む方法では、1回のクエリで数えられる条件は1つだけです。複数の条件の件数を1回のクエリでまとめて求めたいときは、COUNTの中でCASE式を使います(ExcelのCOUNTIF関数のような使い方です)。
【使用イメージ】
SELECT COUNT(CASE WHEN 条件 THEN 1 END) FROM テーブル名;このCASE式は、条件に合う行では「1」を、合わない行ではNULLを返します(ELSEを省略すると、条件に合わない場合の結果はNULLになります)。COUNTはNULLを数えないため、結果として条件に合う行だけが数えられます。なお、THENの後ろは1でなくても、NULLでない値であれば結果は同じです。
【実行クエリ】
SELECT
  COUNT(CASE WHEN location = 'Tokyo' THEN 1 END) AS 東京の受験者数,
  COUNT(CASE WHEN point >= 90 THEN 1 END)        AS 高得点者数,
  COUNT(CASE WHEN point IS NULL THEN 1 END)      AS 点数未登録者数
FROM test;
【実行結果】
| 東京の受験者数 | 高得点者数 | 点数未登録者数 |
| 2 | 3 | 1 |
WHERE句を使った実行クエリ1・2と同じ件数を、1回のクエリでまとめて求められました。
注意したいのは、ELSEに0を指定してしまうケースです。0はNULLではないため、COUNTは条件に合わない行の「0」も数えてしまい、結果が全行数になります。
【誤った例】
SELECT COUNT(CASE WHEN location = 'Tokyo' THEN 1 ELSE 0 END) AS 東京の受験者数 FROM test;【実行結果】
| 東京の受験者数 |
| 6 |
Tokyoは2件のはずが、6件になってしまいました。ELSEを書く場合は「ELSE NULL」にするか、「SUM(CASE WHEN 条件 THEN 1 ELSE 0 END)」のように、COUNTではなくSUMで1を合計する書き方にしましょう(どちらも結果は2になります)。
CASE式はDISTINCTと組み合わせることもできます。THENの後ろに1ではなく列名を書き、COUNT(DISTINCT …)で囲むと、条件に合う行だけを対象に「値の種類の数」を数えられます。たとえば、90点以上の受験者がいる試験地の数を求めてみましょう。
【実行クエリ】
SELECT COUNT(DISTINCT CASE WHEN point >= 90 THEN location END) AS 高得点者がいる会場数 FROM test;【実行結果】
| 高得点者がいる会場数 |
| 3 |
90点以上の受験者はTanakaさん(Tokyo)、Suzukiさん(Osaka)、Inoueさん(Fukuoka)の3人です。条件に合わない行はCASE式がNULLを返すため数えられず、Tokyo・Osaka・Fukuokaの3種類として数えられます。

グループごとに件数を数える:GROUP BY
GROUP BYとCOUNTの組み合わせ
【使用イメージ】
SELECT 列名, COUNT(*) FROM テーブル名 GROUP BY 列名;COUNTと、データをグループ化するGROUP BY句を組み合わせると、グループごとの件数を集計できます。
これまでのクエリのようにGROUP BYを書かずにCOUNTを使うと、テーブル全体が1つのグループとして扱われるため、結果は必ず1行になります。GROUP BYで「試験地ごと」のようにグループの単位を指定すると、グループの数だけ結果の行が返ります。今回のテーブルでは、6行のデータが4つの試験地にまとめられ、結果は4行になります。
【実行クエリ】
SELECT location AS 試験地, COUNT(*) AS 受験者数
FROM test
GROUP BY location
ORDER BY location;
【実行結果】
| 試験地 | 受験者数 |
| Fukuoka | 1 |
| Nagoya | 1 |
| Osaka | 2 |
| Tokyo | 2 |
試験地ごとの受験者数が求められました。GROUP BYだけでは結果の並び順が保証されないため、ORDER BY句で並び順を指定しています。
受験者数の多い順に並べたい場合は、ORDER BY句にCOUNT(*)を指定して降順(DESC)にします。
【実行クエリ】
SELECT location AS 試験地, COUNT(*) AS 受験者数
FROM test
GROUP BY location
ORDER BY COUNT(*) DESC, location;
【実行結果】
| 試験地 | 受験者数 |
| Osaka | 2 |
| Tokyo | 2 |
| Fukuoka | 1 |
| Nagoya | 1 |
OsakaとTokyoのように件数が同じグループどうしの順番は、件数だけでは決まりません。「, location」のように2つ目の並び替え条件を付けておくと、実行するたびに順番が変わることを防げます。また、「ORDER BY 2 DESC」のようにSELECT句の列の位置(番号)で指定する書き方もありますが、列の順番を入れ替えたときに並び順も変わってしまいます。MySQLでは公式リファレンス(SELECT Statement)で非推奨とされているため、COUNT(*)や別名で指定しましょう。
なお、グループ化する列にNULLがある場合、NULLの行は「NULL」という1つのグループにまとめられます。このグループを結果から除きたいときは、「WHERE location IS NOT NULL」のようにWHERE句で除外します。COUNT(location)のように引数を列名にしても、NULLのグループは件数0として結果に残るので注意しましょう。
 【SQL】「GROUP BY」句とは?基本構文から使用例まで詳しく解説
▶
HAVINGで件数を条件に絞り込む
WHERE句は、グループ化する前の行を絞り込む条件です。そのため、COUNTの結果をWHERE句の条件に使うことはできません。「受験者が2人以上の試験地」のように、集計した件数で絞り込みたい場合はHAVING句を使います。
【実行クエリ】
SELECT location AS 試験地, COUNT(*) AS 受験者数
FROM test
GROUP BY location
HAVING COUNT(*) >= 2
ORDER BY location;
【実行結果】
| 試験地 | 受験者数 |
| Osaka | 2 |
| Tokyo | 2 |
受験者が1人のNagoyaとFukuokaが除かれ、2人以上のOsakaとTokyoだけが表示されました。
同じ条件をWHERE句に書くと、エラーになります。
【誤った例】
SELECT location AS 試験地, COUNT(*) AS 受験者数
FROM test
WHERE COUNT(*) >= 2
GROUP BY location;
-- ERROR 1111 (HY000): Invalid use of group functionMySQLでは「集計関数の使い方が正しくない」という意味のエラーが表示されます。前述のとおり、WHERE句で行を絞り込む時点ではまだグループができておらず、試験地ごとの件数が決まっていないためです。COUNTを条件に使うときは、WHEREではなくHAVINGに書くと覚えておきましょう。WHERE句とHAVING句の違いを整理すると、次のとおりです。
| 句 | 絞り込む対象 | 例 |
| WHERE | 集計する前の行 | WHERE location = 'Tokyo' |
| HAVING | GROUP BYで集計した後のグループ | HAVING COUNT(*) >= 2 |
なお、「HAVING COUNT(*) >= 2」(または「> 1」)は、同じ値が2件以上ある=重複している値を探すときにもそのまま使えます。会員のメールアドレスや商品コードなど、本来1件しかないはずの列に重複がないかを確認したいときは、その列でGROUP BYして件数が2以上のグループを表示しましょう。
 【SQL】HAVINGの使い方とWHEREとの違いを解説
▶
COUNT(*)とCOUNT(1)の違い
COUNT(1)が全行数になる理由
COUNT(1)は、各行で「1」という式を評価し、その値がNULLでない行を数えます。1はどの行でもNULLにならない定数なので、結果としてすべての行が数えられ、COUNT(*)と同じ結果になります。
【実行クエリ】
SELECT COUNT(*) AS アスタリスク, COUNT(1) AS 定数1, COUNT(0) AS 定数0 FROM test;【実行結果】
| アスタリスク | 定数1 | 定数0 |
| 6 | 6 | 6 |
同じ理由で、COUNT(0)やCOUNT(2)もすべての行を数えます。一方、COUNT(NULL)のようにNULLを指定すると、数える値が1つもないため結果は0になります(SQL Serverなど、エラーになるデータベースもあります)。
パフォーマンスの差とどちらを使うべきか
「COUNT(1)の方が速い」と紹介されることもありますが、主要なデータベースでは実用上の差はほとんどありません。
| データベース | COUNT(*)とCOUNT(1)の扱い |
| MySQL(InnoDB) | 公式マニュアルに「同じ方法で処理され、性能差はない」と明記されています。 |
| Oracle Database | オラクル社のQ&Aサイト「Ask TOM」で、同じ処理になると説明されています。 |
| PostgreSQL | COUNT(1)は行ごとに「1」を評価する分、COUNT(*)よりわずかに遅くなる場合があります。PostgreSQL 19(2026年9月時点でベータ版)では、COUNT(1)を自動的にCOUNT(*)へ置き換える最適化が開発版に取り込まれています。 |
また、COUNT(*)の「*」は、SELECT *のように全列を読み込む指定ではありません。どの列やインデックスを読んで行を数えるかは、データベースが最適な方法を選びます(たとえばMySQLのInnoDBは、最も小さいセカンダリインデックスを使って行を数えます)。
性能を理由にCOUNT(1)を選ぶ必要はないため、「行の数を数える」という意図がそのまま伝わるCOUNT(*)を使うのがおすすめです。COUNT(1)は、なぜ全行数になるのかを知らない人には意図が伝わりにくい書き方です。
SQLのCOUNTに関するよくある質問
該当する行がないとき、COUNTの結果はどうなる?
条件に合う行が1件もない場合、COUNTはNULLではなく0を返します。一方、SUM・AVG・MAX・MINは対象の行がないとNULLを返します。
【実行クエリ】
SELECT COUNT(*) AS 件数, SUM(point) AS 合計点 FROM test WHERE location = 'Sapporo';【実行結果】
| 件数 | 合計点 |
| 0 | NULL |
列名とCOUNTを一緒にSELECTするとエラーになるのはなぜ?
「SELECT location, COUNT(*) FROM test;」のように、集計関数ではない列とCOUNTを並べてSELECTすると、多くのデータベースでエラーになります。GROUP BYがないとテーブル全体が1つのグループになり、COUNTは6行をまとめて1つの値にします。このとき、locationをどの行の値で表示すればよいかが決まらないからです。
【MySQL 8.0以降でのエラー例】
SELECT location, COUNT(*) FROM test;
-- ERROR 1140 (42000): In aggregated query without GROUP BY, expression #1 of SELECT list contains nonaggregated column 'データベース名.test.location'; this is incompatible with sql_mode=only_full_group_by
「GROUP BYのない集計クエリで、SELECT句の1つ目(location)が集計されていない」という意味のエラーです。
列ごとの件数を表示したい場合は、「GROUP BY location」を付けてグループ化しましょう(前述の「GROUP BYとCOUNTの組み合わせ」を参照)。なお、MySQLの設定(ONLY_FULL_GROUP_BYの無効化)やSQLiteなど、エラーにならない環境もありますが、表示される値が意図通りになる保証はありません。
件数が0のグループも表示するには?
GROUP BYで集計すると、データが1件もないグループは結果に表示されません。件数0のグループも表示したい場合は、グループの一覧を持つテーブルを基準にLEFT JOINし、COUNT(*)ではなくCOUNT(列名)で数えます。
たとえば、Tokyo・Nagoya・Osaka・Fukuoka・Sapporoの5会場を登録した会場テーブル(venue)があるとします。
【実行クエリ】
SELECT v.location AS 試験地, COUNT(t.id) AS 受験者数
FROM venue v
LEFT JOIN test t ON t.location = v.location
GROUP BY v.location
ORDER BY v.location;
【実行結果】
| 試験地 | 受験者数 |
| Fukuoka | 1 |
| Nagoya | 1 |
| Osaka | 2 |
| Sapporo | 0 |
| Tokyo | 2 |
受験者がいないSapporoは、LEFT JOINによってtest側の列がすべてNULLの行として結合されます。COUNT(t.id)はこのNULLを数えないため0になりますが、COUNT(*)にすると行そのものを数えるため1になってしまいます。
また、LEFT JOINの代わりにINNER JOIN(内部結合)を使うと、testテーブルに一致する行がないSapporoは結果から消えてしまいます。件数0のグループを表示するには、「LEFT JOINで結合する」「COUNTの引数を結合相手(test側)の列にする」の2つがそろっている必要があります。
COUNT以外の集計関数
SQLにはCOUNTのほかにも、合計値や平均値などを求める集計関数があります。COUNT以外の集計関数は、対象の列がNULLの行を除いて計算します。
| 集計関数 | 用途 |
| COUNT | 行数・件数を求める |
| SUM | 合計値を求める |
| AVG | 平均値を求める |
| MAX | 最大値を求める |
| MIN | 最小値を求める |
NULLを除いて計算するため、平均値(AVG)の分母になるのはCOUNT(*)ではなくCOUNT(列名)の件数です。サンプルテーブルで確認してみましょう。
【実行クエリ】
SELECT COUNT(*) AS 全行数, COUNT(point) AS 点数あり, SUM(point) AS 合計点, AVG(point) AS 平均点 FROM test;【実行結果】
| 全行数 | 点数あり | 合計点 | 平均点 |
| 6 | 5 | 445 | 89.0000 |
平均点は「445 ÷ 5 = 89」で、pointがNULLのTakahashiさんは分母に含まれていません(実行結果はMySQLの場合です。小数点以下の表示はデータベースによって異なります)。NULLの行も0点として6人で平均したい場合は、COUNT(*)で割るなど、分母を意識して書き分ける必要があります。
それぞれの使い方やGROUP BYと組み合わせた集計の例は、こちらの記事で紹介しています。
【SQL】「GROUP BY」句とは?基本構文から使用例まで詳しく解説
▶
SQL関連記事
- RDBを操作するデータベース言語「SQL」とは?
- RDB以外のデータベース管理システム「NoSQL」とは?
- RDB管理システム「MySQL」とは?
- RDB管理システム「PostgreSQL」とは?
- RDB管理システム「SQL Server」とは?
- RDB管理システム「SQLite」とは?
- ブラウザ上でMySQLを管理できる「phpMyAdmin」とは?
- データを抽出する「SELECT」文
- データを追加する「INSERT」文
- データを削除する「DELETE」文
- データを更新する「UPDATE」文
- テーブル構造を変更する「ALTER TABLE」文
- 抽出条件を指定する「WHERE」句
- 抽出条件を指定する「HAVING」句
- 複数の抽出条件をまとめる「IN」句
- 重複レコードを除外する「DISTINCT」
- 抽出範囲を指定する「BETWEEN」演算子
- 抽出条件を満たすレコードの存在の有無を調べる「EXISTS」句
- レコード件数を取得する集計関数「COUNT」関数
- レコードをグループ化する「GROUP BY」句
- 抽出結果を並び替える「ORDER BY」句
- テーブル間のデータを結合する「JOIN」句
- 内部結合「INNER JOIN」句
- 抽出結果を統合して表示する「UNION」句
- データの曖昧検索「LIKE」句
- データの取得件数を制限する「LIMIT」句
- 条件分岐処理「CASE」式
- 「NULL」の扱い方
- 「主キー」とは?
- 「外部キー」とは?
SQLの勉強方法は?
書籍やインターネットで学習する方法があります。昨今では、YouTubeなどの動画サイトやエンジニアのコミュニティサイトなども充実していて多くの情報が手に入ります。
そして、より効率的に知識・スキルを習得するには、知識をつけながら実際に手を動かしてみるなど、インプットとアウトプットを繰り返していくことが重要です。特に独学の場合は、有識者に質問ができたりフィードバックをもらえるような環境があると、理解度が深まるでしょう。
ただ、SQLに限らず、ITスキルを身につける際、どうしても課題にぶつかってしまうことはありますよね。特に独学だと、わからない部分をプロに質問できる機会を確保しにくく、モチベーションが続きにくいという側面があります。独学でモチベーションを維持する自信がない人にはプログラミングスクールという手もあります。費用は掛かりますが、その分スキルを身につけやすいです。しっかりと知識・スキルを習得して実践に活かしたいという人はプログラミングスクールがおすすめです。
プログラミングスクールならテックマニアがおすすめ!
ITスキル需要の高まりとともにプログラミングスクールも増えました。しかし、どのスクールに通うべきか迷ってしまう人もいるでしょう。そんな方にはテックマニアをおすすめします!これまで多くのITエンジニアを育成・輩出してきたテックマニアでもプログラミングスクールを開講しています。
<テックマニアの特徴>
・たしかな育成実績と親身な教育 ~セカンドキャリアを全力支援~
・講師が現役エンジニア ~“本当”の開発ノウハウを直に学べる~
・専属講師が学習を徹底サポート ~「わからない」を徹底解決~
・実務ベースでスキルを習得 ~実践的な凝縮カリキュラム~
このような特徴を持つテックマニアはITエンジニアのスタートラインとして最適です。
話を聞きたい・詳しく知りたいという方はこちらからお気軽にお問い合わせください。